预测性维护希望在设备停机前识别状态劣化,让维修人员安排检查和备件,而不是把每次波动都变成紧急停机。方案应从具体故障模式出发,选择可反映机理的振动、温度、电流或声音测点,建立数据、告警与工单的闭环。边缘工控机承担连续采集、特征计算、推理与断网缓存。
现场任务与数据条件
不同设备的磨损表现不同:轴承故障可能表现为振动频段变化,电机异常可能伴随电流和温升,泵的工况又与流量和压力有关。项目开始应和设备专家列出关键失效模式、检查动作及提前量要求,不能用一个通用“健康分数”覆盖所有设备。
要记录负载、转速、启停和保养事件,区分工况变化与故障发展。没有故障标签时可以先做偏离检测,但应把输出称为状态异常,并通过维修复核积累故障证据。传感器安装位置、采样率和校准会决定能否观察到目标故障。
系统架构与数据闭环
传感器或PLC信号进入边缘节点后,按统一时间轴做清洗、窗口计算与特征提取。系统将异常趋势、持续时间、相关变量和波形证据关联设备资产号,推送给维护平台生成待核查任务;维修完成后回写故障原因和处理措施。
边缘侧保留最近高频片段及告警,中心用于长期趋势和模型迭代。网络断开时继续采集和判定,恢复后按事件ID补传。对于高风险设备,原有保护阈值与停机联锁保持独立,预测性维护不替代设备安全保护。
预警应包含可执行的检查建议。例如“某电机振动特征持续偏离同负载基线,建议在下一计划停机窗口检查轴承与联轴器”,并附趋势和原始片段;不宜在未经拆检时直接写成“轴承即将损坏”。维护人员可根据设备重要度安排复核优先级。
模型更新要考虑设备换件后的新基线。若轴承、传感器或采集位置改变,应标记变更时间,避免新旧数据直接混训。对传感器自身故障设独立健康检查,让数据缺失或饱和被识别为测量问题。
环节 | 建议明确的交付内容 | 现场核对重点 |
|---|
输入与采集 | 设备清单、信号或图像、设备ID和时间戳 | 数据权限、缺失值、同步与协议 |
边缘处理 | 预处理、模型或规则、事件缓存 | 并发、时延、版本、断网恢复 |
业务与执行 | 结果接收、人工复核、控制器边界 | 权限、联锁、日志与异常回退 |
工控机选型与集成
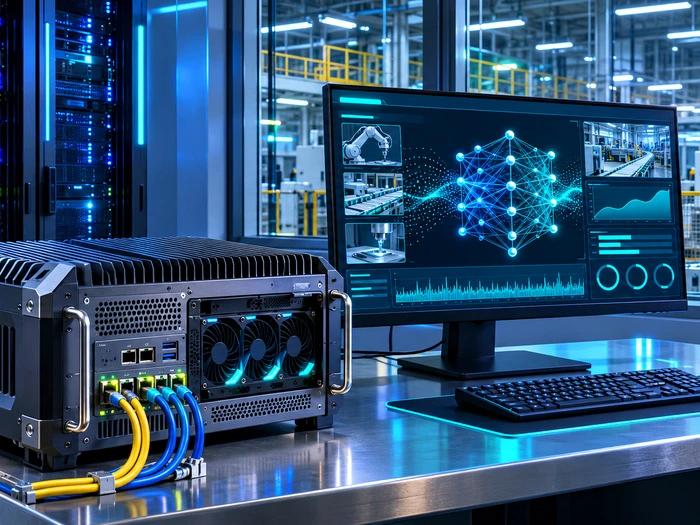
N-BOX-S6适合多设备通信和边缘分析的候选;高频信号、多模型并行或更复杂推理可评估N-BOX-S9。选型重点包括采样链路、时间同步、连续写盘、内存及柜内散热,不能仅以AI算力峰值决定。
若需要特定采集卡、连接器或机箱安装结构,先核对实际扩展和供电,再评估x86主板及整机定制。硬件老化测试不等于现场故障预测模型已经达到某个准确率。
采购配置时建议同时提供目标模型及运行时版本、摄像头或传感器清单、现有PLC/MES/SCADA接口、现场供电与安装尺寸,以及连续运行和数据留存要求。派勤可据此核对标准整机、工业主板及x86 OEM/ODM改型方向。实际软件、采集卡、加速器和现场协议的兼容性以联合测试为准。
软硬件联调时,应先建立一份逐项可核对的接口清单:信号来自何处、由谁授权读取、数据以什么单位和周期产生、结果送往哪个系统、消息失败后怎样重试。对每个接口指定负责人和测试样例,保存正常、缺失、重复、延迟及错误格式的处理记录。涉及第三方算法或平台时,明确部署包、驱动、操作系统、协议适配与远程升级分别由哪一方提供。这样在扩线、换机或故障排查时,现场人员可以按记录定位问题。
实施步骤与验收
从少量同类设备和已知故障模式试点,至少覆盖正常负载变化和维护周期。按设备统计提前预警时间、误报频率、漏报、告警到检修的闭环时间,并记录被忽略告警的原因。验证时避免把同一故障事件的相邻时间窗同时放入训练与测试。
项目可按需求确认、样机联调、现场试点、批量部署四步推进。样机阶段冻结硬件版本与软件镜像,记录接口、驱动、资源占用和热状态;试点阶段保留人工复核与旧流程对照。进入批量前,按量产配置确认开机、接口、温度、存储与恢复日志,并落实现场维护、版本回退和备件机制。
需要定制时,先明确不能由标准机型满足的接口、结构、散热或供货条件,再评审主板、整机、BIOS、外壳与连接器改型。派勤制造测试可采用12小时高温负载连续开机老化测试;这是硬件出厂流程的表述,不代表本应用的算法效果或项目现场测试结果。
常见问题
问:没有历史故障记录能开展吗?
答:可以先做状态基线和异常趋势监测,并同步规范维修记录;不要在无标签时宣称能够准确识别具体故障原因。
问:边缘节点需要接管设备控制吗?
答:一般不需要。它采集状态并输出预警,停机保护和控制仍由现有设备系统承担。
如需评估现场部署,请提供业务目标、设备与数据清单、模型和软件环境、目标节拍或响应时间、安装供电条件及预期数量。这样可以先验证最关键的接口与计算负载,再确定整机或定制方案。